Asistente de IA híbrido y privacidad
Cómo funciona el modo Auto entre Gemma 4 local (LiteRT-LM) y Gemini BYOK, con Portero de Privacidad, límites reales y catálogo de modelos.
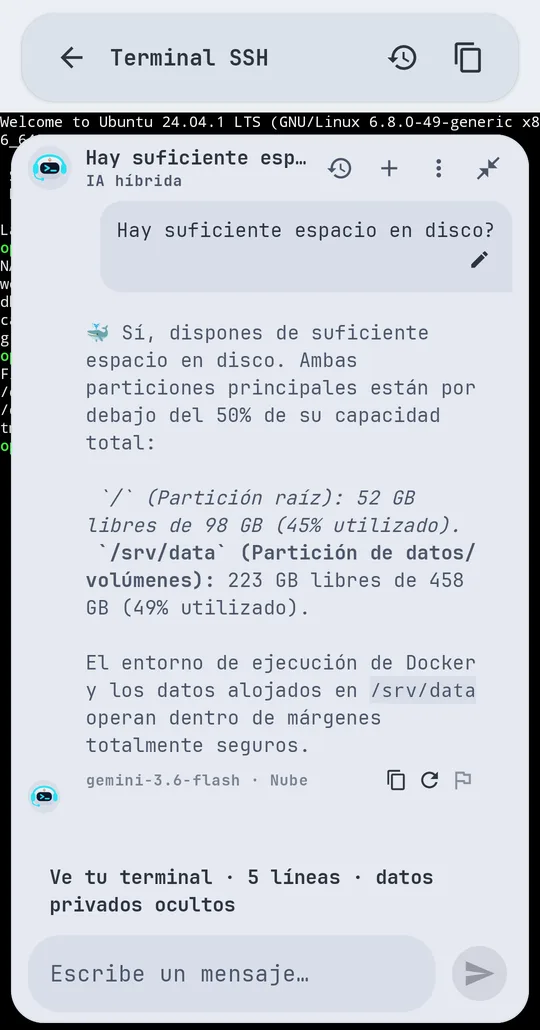
STALMAS incluye un asistente técnico capaz de explicar errores en logs, diagnosticar archivos Compose y ayudarte desde la terminal SSH sin depender de un backend nuestro. Cada respuesta muestra la etiqueta del motor que la generó (CLOUD: o LOCAL:), transmite en streaming con botón de parar, permite chat temporal (no se guarda) y mantiene los chats aislados por servidor o entorno.
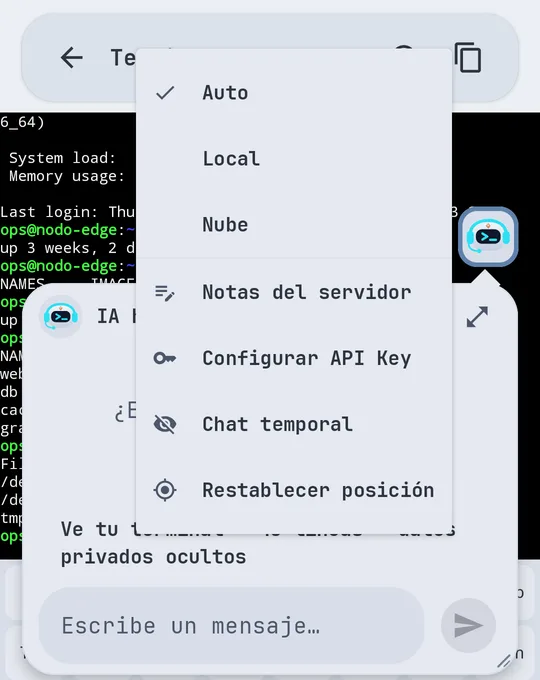
Dos motores: Local (Gemma 4) y Nube (Gemini BYOK)
- IA Local (Pro): ejecuta modelos Gemma 4 optimizados en formato
.litertlmsobre LiteRT-LM en un proceso aislado (:ai) dentro de tu Android. No realiza ninguna petición de red al consultar y usa el acelerador Auto por defecto (elige GPU o CPU según tu equipo y modelo, con ajuste manual opcional). - IA en la nube (Free y Pro): conecta directamente tu teléfono con Google Gemini usando tu propia clave API (BYOK — Bring Your Own Key). Incluye selector de modelos filtrados por tu clave, comprobador estimado de capa (Gratis / De pago) y contador local de uso de los últimos 7 días.
- Modo Híbrido
Auto/Local/Cloud: en Pro puedes priorizar la ejecución privada en el teléfono («IA Local primero»), fijar «Solo IA Local» por servidor o consultar tu clave de Gemini cuando necesites mayor ventana de contexto.
Nota sobre la capa gratuita de Gemini: Como indica la propia interfaz de Google y recordamos en los ajustes de STALMAS, en la capa gratuita de Gemini API el contenido enviado puede ser usado por Google para mejorar sus productos. Para máxima privacidad usa modelos locales Gemma 4 o revisa la configuración de facturación de tu clave.
Modelos locales oficiales catalogados
Los archivos .litertlm disponibles en models.json son (requieren Android 12+, CPU de 64 bits y espacio libre igual al tamaño del modelo + 500 MB):
| Modelo | Licencia | RAM mínima recomendada | Descarga aproximada |
|---|---|---|---|
Gemma 4 E2B IT (gemma-4-e2b-it) |
Apache 2.0 | 6 GB | ~2,41 GiB |
Gemma 4 E4B IT (gemma-4-e4b-it) |
Apache 2.0 | 8 GB | ~3,41 GiB |
También puedes buscar modelos de chat compatibles en Hugging Face o importar un archivo .litertlm desde tu dispositivo mediante el selector estándar de Android (SAF), descartando variantes incompatibles -gpu. / -web..
Portero de Privacidad (PrivateInfoDetector + PseudonymMap)
Antes de enviar contexto a la nube:
- Analiza IPs (IPv4 e IPv6), dominios, URLs, contraseñas, claves, tokens y cadenas de conexión.
- Modo «ocultar y enviar» (Free y nube en Pro): el portero no bloquea tu flujo; sustituye los datos sensibles por
[REDACTED], envía la consulta y muestra un aviso con el número de datos ocultos y la opción «ver qué se ocultó». - Seudónimos reversibles (Pro): en la nube sustituye direcciones IP y hosts por etiquetas reversibles (
[IP_1],[HOST_1]) y devuelve tus IPs/hosts reales solo en tu pantalla. Las contraseñas, claves y tokens nunca vuelven (permanecen como[REDACTED]). En modoAutocon modelo local instalado, las consultas con datos privados se desvían al teléfono automáticamente.
Confirmación de comandos peligrosos
Cuando el asistente sugiere un comando destructivo (como rm -rf o docker system prune), STALMAS exige confirmación explícita obligatoria antes de ejecutarlo en la terminal, incluso si tienes activada la ejecución rápida. El asistente nunca ejecuta comandos ni modifica archivos por su cuenta.
Límites reales de contexto y memoria
| Concepto | Free (nube) | Pro (nube) | Pro (IA local · LiteRT-LM) |
|---|---|---|---|
| Memoria reciente en el turno | 6 mensajes (3 intercambios) | 20 mensajes (10 intercambios) | Hasta 6 mensajes dentro del 40 % del presupuesto |
| Contexto de terminal | 4.000 caracteres | 16.000 caracteres | 1.500 caracteres (según presupuesto) |
| Contexto de stack (Compose) | Pegar a mano | 16.000 caracteres (principio) | Hasta 1.500 caracteres |
| Contexto de logs | Pegar a mano | Últimas 100 líneas filtradas (máx. 16.000 caracteres) | Últimas 100 líneas filtradas (máx. 1.500 caracteres) |
| Notas por servidor | — | 1.500 caracteres | 1.500 caracteres |
| Ventana total | Según el modelo Gemini elegido | Según el modelo Gemini elegido | 4.000 caracteres compartidos (maxNumTokens <= 4.000) |
Además, Pro desbloquea análisis en un toque de archivos Docker Compose con aplicación directa al editor, revisión de limpieza segura en imágenes y volúmenes, skills personalizadas (SKILL.md), búsqueda en todo el historial y exportación a Markdown.